
Инженерните екипи, разработващи софтуер с изкуствен интелект, постоянно се сблъскват с един и същ избор: да плащат за непредвидими облачни изчислителни ресурси или да инвестират в собствен хардуер, който да остане под техен контрол. Появата на отворени тегла от ранга на GLM-5.3 на Z.ai отново поставя този въпрос на преден план.
На пръв поглед новият Mac Studio с M5 Ultra изглежда като машината, която може да промени правилата. Apple вече предлага до 512 GB unified memory и 1.2 TB/s memory bandwidth — характеристики, които поставят Mac Studio в съвсем различна категория спрямо традиционните настолни компютри. Това е достатъчно памет, за да се поберат модели, които доскоро изглеждаха изцяло извън обсега на локален хардуер.
GLM-5.3 обаче е особено интересен случай. Моделът има около 753 милиарда параметъра, но е Mixture-of-Experts архитектура с приблизително 40 милиарда активни параметъра при обработката на един токен. Контекстният прозорец достига до 1 048 576 токена. Именно комбинацията от огромен общ брой параметри, MoE архитектура и екстремно дълъг контекст показва къде се намират реалните граници на един Mac Studio. Въпросът следователно вече не е просто „може ли GLM-5.3 да се стартира на Mac Studio?“. По-важният въпрос е дали може да бъде стартиран с достатъчно висока прецизност, достатъчно свободна памет и достатъчна производителност, за да представлява реален работен инструмент.
Аритметика на теглата и физическите граници на паметта
Първият проблем е размерът на самия модел.
GLM-5.3 е MoE модел с приблизително 753 милиарда параметъра. При 16-битова прецизност всяко тегло изисква два байта. Простата сметка е:
753 млрд. × 2 байта ≈ 1.506 TB
Това е само паметта за самите тегла.
Следователно пълната BF16 версия не може да бъде заредена в един Mac Studio M5 Ultra с 512 GB unified memory. Разликата не е малка — необходими са приблизително три пъти повече памет от наличната в максималната конфигурация на машината.
Тук обаче MoE архитектурата променя картината по отношение на изчисленията. При всеки токен не се използват всичките 753 милиарда параметъра. Активният параметърен бюджет е приблизително 40 милиарда параметъра на токен.
Това означава, че изчислителното натоварване не е еквивалентно на плътен 753B модел. Но това не решава автоматично проблема с паметта: голямата част от експертите трябва да останат достъпни, за да може маршрутизаторът да избира различни експерти за различните токени.
Точно тук се намира една от фундаменталните разлики между изчислителен размер и размер на checkpoint-а.
Можете да активирате само 40B параметъра за конкретен токен, но това не означава, че можете да изхвърлите останалите стотици милиарди параметри от паметта.
M5 Ultra вече е реалният тест
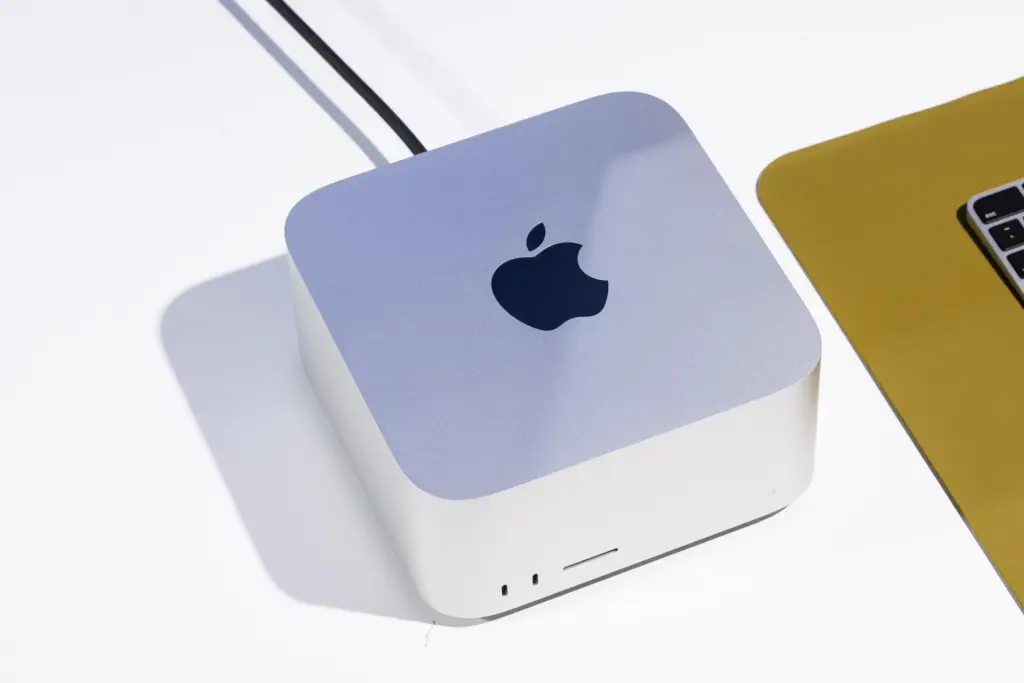
При предишните поколения можеше да се говори само хипотетично за машина с 512 GB unified memory. Това вече не е необходимо.
Актуалният Mac Studio с M5 Ultra се предлага с до 512 GB unified memory и 1.2 TB/s memory bandwidth. Максималната конфигурация включва 36-ядрен CPU, 80-ядрен GPU и 32-ядрен Neural Engine.
Това прави M5 Ultra изключително интересна платформа за големи локални модели.
Но 512 GB не означава, че всичките 512 GB могат безусловно да бъдат третирани като свободен буфер за моделни тегла. Операционната система, runtime-ът, Metal и самото приложение също използват unified memory. Освен това inference системата трябва да осигури пространство за KV cache, временни буфери, активни тензори и други структури.
Следователно модел, който теоретично заема 380–400 GB след квантуване, не трябва да се разглежда като модел с „още 120 GB свободни“.
Тези 120 GB са оперативен резерв, който постепенно се консумира от останалата част на inference pipeline-а.
Квантуването променя играта
За да стане GLM-5.3 достъпен за единичен M5 Ultra, квантуването е практически неизбежно.
Идеализираният размер на теглата при различна битова дълбочина изглежда приблизително така:
- BF16 — около 1.5 TB
- 8-bit — около 753 GB
- 4-bit — около 376.5 GB
- 3-bit — около 282 GB
- 2-bit — около 188 GB
Това са математически оценки. Реалните файлове са по-големи заради scale параметри, metadata, packing и спецификите на конкретния quantization формат.
Практическите Q4 варианти на GLM-5.3 са от порядъка на 380–400 GB, в зависимост от формата и реализацията.
Това означава нещо важно: 4-bit GLM-5.3 вече може да се побере по размер на теглата в 512 GB unified memory на един M5 Ultra.
Това е съществена разлика спрямо твърдението, че моделът изобщо не може да бъде зареден.
Проблемът просто се премества.
Вместо „може ли да поберем модела?“ въпросът става:
„Колко памет остава за контекста и inference runtime-а и каква производителност получаваме?“
4-bit не означава 4 пъти по-бързо
Квантуването намалява обема на теглата, но не превръща автоматично модела в малък модел.
При 4-bit GLM-5.3 размерът на теглата е приблизително 380–400 GB. Това е значително под 1.5 TB при BF16, но все пак представлява огромен масив от данни, който трябва да бъде използван при генерирането.
Тук memory bandwidth става решаващ фактор.
При авторегресивния decode процес системата трябва постоянно да извлича големи количества моделни тегла от unified memory. Следователно производителността при batch size 1 и интерактивен inference често е ограничена не толкова от максималните TFLOPS на GPU, колкото от това колко ефективно се доставят данните до изчислителните блокове.
M5 Ultra предлага 1.2 TB/s memory bandwidth.
Ако разделим тази стойност на идеализиран модел с 380 GB тегла, получаваме:
1200 / 380 ≈ 3.16
Това не е прогноза за реалните токени в секунда.
Това е само груба memory-bandwidth roofline граница — колко пъти в секунда би могла теоретично да бъде прочетена цялата маса от тегла при идеално използване на номиналната пропускателна способност.
Реалният throughput зависи от quantization kernel-ите, memory access pattern-ите, GPU utilization, активните експерти, KV cache, batch size, конкретния inference engine и начина, по който runtime-ът управлява MoE маршрутизацията.
Следователно от числото 1.2 TB/s не бива механично да се извежда конкретна скорост от типа „3.2 токена в секунда“.
Това би било фалшива точност.
Важният извод е друг: дори при 4-bit компресия огромният размер на модела поставя системата в режим, в който memory subsystem става критичният ресурс.
Mixture-of-Experts не решава проблема с паметта
MoE архитектурата е една от причините GLM-5.3 изобщо да бъде практически интересен.
Моделът съдържа приблизително 753B параметъра, но около 40B са активни за всеки токен. Това драматично намалява количеството изчисления спрямо плътен модел със същия общ размер.
При всеки токен маршрутизаторът избира ограничен набор експерти. Това означава, че изчислителният бюджет е много по-близък до този на модел от десетки милиарди параметри, отколкото до плътен 753B модел.
Но това не означава, че паметта също се свива до 40B параметъра.
Експертите трябва да бъдат достъпни, когато маршрутизаторът ги избере. Следователно голямата част от checkpoint-а трябва да остане в паметта или да бъде доставяна от по-бавен storage tier.
Това е фундаменталният компромис:
MoE намалява изчисленията, но не премахва необходимостта от съхраняване на голям модел.
А какво става с 1 милион токена контекст?
Тук ситуацията става още по-интересна.
GLM-5.3 поддържа контекст до 1 048 576 токена. Архитектурата използва DeepSeek-style Sparse Attention, което е предназначено именно да намалява разхода при дълъг контекст.
Това е важно, защото оригиналната логика „128k контекст означава X GB KV cache“ вече не може просто да бъде пренесена към GLM-5.3.
Размерът на KV cache зависи от действителната attention архитектура, броя KV heads, head dimension, precision и конкретната inference реализация.
При GLM-5.3 sparse attention механизмът е проектиран да намалява изчислителната цена при много дълъг контекст. Това е едно от ключовите инженерни решения, позволяващи на модела да работи с контекст от порядъка на един милион токена.
Но „поддържа 1M context“ не означава, че всяка 512 GB машина ще може комфортно да държи 1M-token сесия заедно с огромния quantized checkpoint.
Тук отново се появява ограничението на unified memory.
Колкото повече памет е заета от теглата, толкова по-малко остава за контекст, междинни буфери и останалата част от inference процеса.
Следователно максималният контекст на модела и практическият контекст на конкретния хардуер са две различни неща.
2-bit квантуването не е магическият изход
Ако 4-bit моделът заема около 380–400 GB, логичната следваща стъпка е да се премине към 3-bit или 2-bit представяне.
Това действително намалява размера.
При идеализирана сметка 3-bit версията на 753B параметъра е около 282 GB, а 2-bit версията — около 188 GB, преди overhead-а на конкретния формат.
На теория това оставя много повече място за runtime и контекст.
Но тук започва класическият компромис между капацитет и качество.
Квантуването не намалява равномерно грешката във всички части на модела. Различните слоеве и групи тегла имат различна чувствителност към загубата на прецизност. Именно затова съвременните quantization формати използват различни scale фактори, групиране и смесена прецизност.
Следователно не е коректно да се казва, че „2-bit автоматично унищожава логическата способност на модела“.
Това трябва да бъде измерено с конкретния checkpoint, quantization метод и benchmark.
Но инженерният принцип остава валиден: колкото по-агресивна е квантизацията, толкова по-голям е рискът от измерима загуба на качество и толкова по-важен става benchmark-ът на конкретната quantized версия.
Ако 2-bit вариантът спестява стотици гигабайти, но води до значителна загуба на качеството при задачите, заради които е избран 753B модел, икономията на памет може да се окаже лош компромис.
Това е причината да няма универсален отговор „Q2 е достатъчно“.
Заблудата за SSD като разширение на паметта
Остава друг очевиден въпрос: ако 512 GB не стигат удобно, защо просто да не използваме SSD?
Съвременните SSD устройства са изключително бързи при последователно четене и запис. Това обаче не ги превръща в заместител на unified memory за LLM inference.
Разликата не е само в максималната пропускателна способност.
RAM и SSD имат различни характеристики на латентност и достъп. При inference системата трябва непрекъснато да използва множество тензори и да поддържа активното състояние на изчислението.
Ако критични части от модела постоянно трябва да бъдат прехвърляни между SSD и паметта, системата се превръща в storage-bound pipeline.
Това може да бъде полезно като механизъм за offloading, когато целта е изобщо да се стартира модел, който не се побира в RAM.
Но е фундаментално различно от това моделът да се намира изцяло в бързата unified memory.
Следователно SSD offloading трябва да се разглежда като компромис за капацитет, а не като безплатно разширение на RAM.
Thunderbolt 5 вече променя сметката
Тук има една важна промяна спрямо старите представи за Mac клъстерите.
Новият Mac Studio разполага с Thunderbolt 5, а Apple официално посочва възможност за до 120 Gb/s трансфер. Apple също така вече рекламира свързването на множество Mac Studio системи чрез Thunderbolt 5 и RDMA за мащабиране на AI inference.
Още по-важно е, че MLX вече поддържа JACCL — комуникационен backend, използващ RDMA over Thunderbolt.
Това е съществено различно от стария модел „изпращаме тензори през обикновен TCP/IP“.
Според документацията на MLX JACCL е предназначен именно за нисколатентна distributed communication и е необходим за приложения като tensor parallelism при големи модели. Apple/MLX документацията посочва, че RDMA over Thunderbolt може да постигне значително по-ниска латентност от TCP-базирания ring backend.
Това прави клъстер от Mac Studio машини технически много по-интересен, отколкото изглеждаше преди.
Но клъстерът не е един голям Mac
И тук трябва да внимаваме с маркетинговото мислене.
Два Mac Studio с по 512 GB unified memory не се превръщат автоматично в една машина с 1 TB бърза памет.
При distributed inference моделът трябва да бъде разделен между различните възли, а комуникацията между тях става част от изчислителния pipeline.
MLX поддържа distributed inference и JACCL, но JACCL изисква специфична топология: за пълноценна комуникация между възлите трябва да бъде изградена директна fully connected Thunderbolt mesh. Документацията на MLX описва именно такава конфигурация и посочва, че JACCL е предназначен за нисколатентна комуникация между Mac системи.
Това е напредък, но не елиминира физиката.
Ако разделим модела между две или повече машини, всяка стъпка на distributed inference може да изисква комуникация между възлите.
Следователно общият резултат зависи от баланса между:
- локалната memory bandwidth;
- GPU изчислителната мощ;
- размера на тензорите, които се комуникират;
- latency на interconnect-а;
- ефективността на distributed runtime-а;
- начина, по който моделът е partition-нат.
Това вече е истински HPC проблем, а не просто въпрос на „колко RAM имаме“.
Колко Mac Studio са необходими?
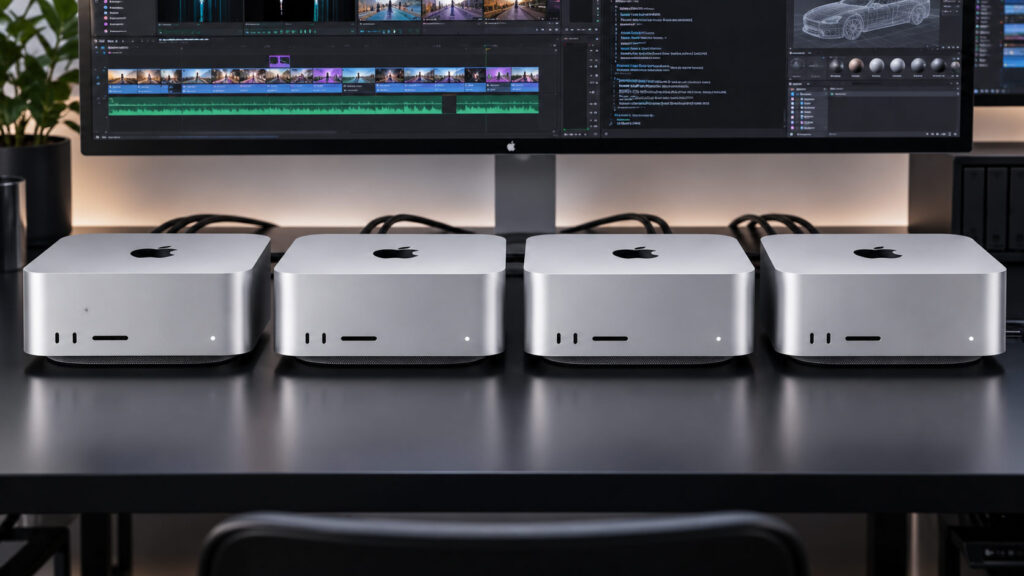
Отговорът зависи от целта.
За BF16 inference един M5 Ultra очевидно не е достатъчен. При около 1.5 TB само за теглата дори максималният 512 GB Mac Studio е далеч под необходимия капацитет.
При FP8 ситуацията също остава извън обсега на единичния Mac Studio: моделът е от порядъка на 750 GB според публикуваните checkpoint размери.
При 4-bit вече се появява реална възможност за единичен M5 Ultra, защото quantized checkpoint от порядъка на 380–400 GB може да бъде поставен в 512 GB unified memory.
Но това е границата на възможното, а не автоматично оптималната работна конфигурация.
При по-дълъг контекст, по-висока прецизност или по-висок throughput допълнителните Mac Studio системи започват да имат смисъл.
Именно тук distributed MLX/JACCL става интересен: вместо да се опитваме да изстискаме огромния модел в една машина, можем да разпределим изчисленията и паметта между няколко възела.
Границата между техническия ентусиазъм и реалната работна среда
Това ни връща към първоначалния въпрос.
Може ли GLM-5.3 да работи локално на Mac Studio M5 Ultra?
Да — но отговорът зависи изцяло от това какво разбираме под „работи“.
Ако целта е proof of concept, 4-bit quantized GLM-5.3 може да бъде поставен в обсега на 512 GB M5 Ultra. Това вече не е чисто теоретична идея.
Ако целта е интерактивна разработка, голям контекст, стабилна производителност и минимални компромиси в качеството, ситуацията е различна.
При 4-bit checkpoint от около 380–400 GB машината има сравнително малък остатъчен бюджет спрямо общите 512 GB. Това оставя по-малко пространство за KV cache, runtime буфери и други операции.
При 3-bit квантуването се освобождава значително повече памет, но цената е потенциално по-голяма загуба на качество.
При 2-bit се получава още повече свободно пространство, но вече е задължително да се гледат реални benchmark-и на конкретния quantization.
А при BF16 или FP8 единичният M5 Ultra просто няма достатъчно физическа памет за целия checkpoint.
Следователно правилният инженерният извод не е:
„GLM-5.3 не може да работи на Mac Studio.“
Това вече би било неточно.
По-точният извод е:
„Единичен Mac Studio M5 Ultra може да достигне до GLM-5.3 чрез агресивна квантизация, но не предлага достатъчен паметови резерв за всички режими на модела. За по-висока прецизност, голям контекст или по-сериозен throughput е необходим distributed setup или хардуер от по-висок клас.“
Това е много по-интересната граница.
Къде всъщност е златната среда?
За локална AI разработка не винаги има смисъл да се преследва най-големият възможен checkpoint.
Ако задачата е програмиране, анализ на документация, локален coding agent или работа с частна кодова база, по-компактен модел може да предложи значително по-добър баланс между:
- скорост;
- качество;
- памет;
- цена;
- дължина на контекста;
- консумация на енергия;
- сложност на deployment-а.
Тук Mac Studio остава изключително силна платформа.
Модели от десетки милиарди параметри са много по-лесни за поставяне в паметта и позволяват значително по-голям оперативен резерв за контекст и runtime.
И това е важна част от избора: локалният AI хардуер не трябва да се оценява само по това кой е най-големият модел, който може да бъде зареден.
Трябва да се оценява по това кой модел може да бъде използван продуктивно.
Кога Mac клъстерът започва да има смисъл?
Ако целта е именно GLM-5.3 и не желаем да приемаме агресивно 2-bit или 3-bit квантуване, следващата логична стъпка е повече от един Mac Studio.
Тук вече имаме реална технологична основа.
Apple официално позиционира новия Mac Studio като машина, която може да бъде клъстерирана за AI чрез Thunderbolt 5 и RDMA. MLX предоставя JACCL backend за тази комуникация и документацията му включва distributed inference на гигантски модели.
Това не превръща Mac Studio в еквивалент на DGX система.
Но означава, че идеята за няколко Mac Studio, работещи заедно като локален AI клъстер, вече не е просто форумна екзотика.
Тя е реален инженеринг вариант.
Въпросът е икономическият.
Две или три машини с максимална памет означават значителна инвестиция, по-сложна конфигурация, повече консумация и повече точки на отказ. При определен мащаб специализираният GPU хардуер може да предложи по-добро съотношение между памет, bandwidth и distributed interconnect.
Mac клъстерът е интересен именно когато приоритетите са локална собственост на данните, unified memory, тиха настолна инфраструктура и macOS/MLX екосистема, а не просто максималният възможен throughput.
Заключение
GLM-5.3 е добър пример защо размерът на един AI модел не може да бъде описан само с броя параметри.
Моделът разполага с около 753 милиарда параметъра, но използва MoE архитектура с приблизително 40 милиарда активни параметъра на токен. Това прави изчислителната задача значително по-достъпна, но не премахва огромния memory footprint на пълния checkpoint. Контекстът от до един милион токена допълнително поставя високи изисквания към memory management-а.
M5 Ultra променя значително сметката. С до 512 GB unified memory и 1.2 TB/s memory bandwidth той вече може да постави агресивно квантуван GLM-5.3 в обсега на една настолна машина.
Но това не означава, че един Mac Studio се превръща в пълноценен заместител на многосистемен GPU inference cluster.
При BF16 моделът е твърде голям.
При FP8 отново надхвърля паметта.
При 4-bit става възможен, но оставя ограничен резерв.
При 3-bit и 2-bit се освобождава памет, но трябва да се приеме потенциална загуба на качество и да се измери реалният ефект върху конкретните задачи.
А когато един Mac вече не е достатъчен, Thunderbolt 5 и RDMA/JACCL дават реален път към distributed inference между няколко Mac Studio системи.
Истинската граница следователно не е „може ли да се стартира GLM-5.3“.
Може.
Истинската граница е дали можете да осигурите едновременно достатъчно памет, достатъчна пропускателна способност, приемливо качество след квантуването, достатъчно контекст и достатъчен throughput, без хардуерът да се превърне в по-голям проблем от самия модел. И точно там единичният Mac Studio M5 Ultra започва да достига физическите си граници.